Haute disponibilité et redondance des infrastructures
La haute disponibilité ne s'achète pas, elle se conçoit : supprimer les points de défaillance uniques, choisir les bons mécanismes de bascule et les tester régulièrement. Méthode et exemples.
La disponibilité d'un service se mesure par le pourcentage de temps pendant lequel il fonctionne. Une disponibilité de 99,9 % autorise environ 8 h 45 d'indisponibilité par an ; 99,99 % en autorise environ 53 minutes. Chaque « neuf » supplémentaire coûte plus cher que le précédent. La haute disponibilité consiste à identifier les points de défaillance et à y répondre avec des mécanismes proportionnés aux besoins.
Objectif : concevoir une infrastructure réseau redondante, comprendre les mécanismes de bascule les plus courants (passerelles redondantes, agrégation, routage, clusters) et organiser des tests.
Définir le besoin avant la technique
Deux indicateurs structurent la réflexion :
- RTO (Recovery Time Objective) : durée maximale d'interruption acceptable.
- RPO (Recovery Point Objective) : quantité maximale de données que l'on accepte de perdre.
Un service de messagerie interne peut tolérer quelques minutes de bascule ; une ligne de production ou un service de paiement beaucoup moins. Ces objectifs déterminent l'architecture, et donc le budget.
Identifier les points de défaillance uniques
Un point de défaillance unique (SPOF) est un composant dont la panne arrête le service. Passez en revue chaque couche :
| Domaine | SPOF fréquents | Réponses |
|---|---|---|
| Énergie | Une alimentation, un onduleur, un circuit électrique | Doubles alimentations sur circuits distincts, onduleurs redondants |
| Physique | Un câble, un module optique, un chemin de câbles | Liens doublés par des chemins différents |
| Commutation | Un commutateur de cœur ou d'accès | Paire de commutateurs, empilement, MLAG |
| Passerelle | Un routeur ou une interface SVI | VRRP, HSRP, GLBP |
| Accès externe | Un seul opérateur, une seule ligne | Double accès, opérateurs et adductions différents |
| Services | Un serveur DNS, DHCP, d'authentification | Serveurs multiples, basculement |
| Humain | Une seule personne connaît la configuration | Documentation, procédures, sauvegardes |
N'oubliez pas les dépendances cachées : deux liens « redondants » qui passent dans la même gaine, deux serveurs sur le même hôte de virtualisation, deux opérateurs qui utilisent la même boucle locale.
Redondance de la passerelle : FHRP
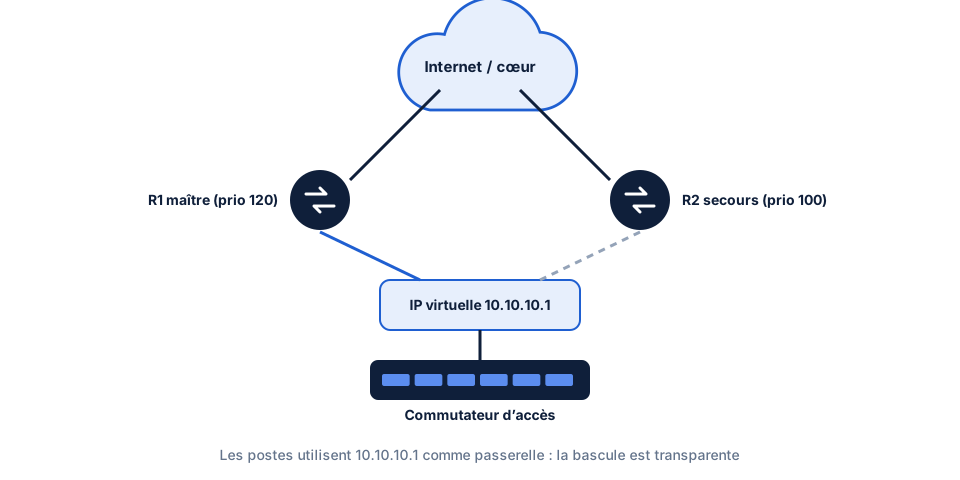
Un poste ne connaît qu'une passerelle par défaut. Si le routeur correspondant tombe, le poste perd tout accès hors de son sous-réseau. Les protocoles de redondance de premier saut (First Hop Redundancy Protocols) partagent une adresse IP virtuelle entre plusieurs routeurs.
| Protocole | Standard | Principe |
|---|---|---|
| VRRP | IETF (RFC 9568 pour VRRPv3) | Un routeur maître, des routeurs de secours ; IPv4 et IPv6 |
| HSRP | Propriétaire Cisco | Routeur actif et routeur de secours |
| GLBP | Propriétaire Cisco | Répartition de charge entre plusieurs routeurs actifs |
Exemple VRRP sur Cisco IOS XE (laboratoire)
! Routeur R1 (maître souhaité)
interface Vlan10
 ip address 10.10.10.2 255.255.255.0
 vrrp 10 address-family ipv4
  address 10.10.10.1 primary
  priority 120
  preempt
  exit-vrrp

! Routeur R2 (secours)
interface Vlan10
 ip address 10.10.10.3 255.255.255.0
 vrrp 10 address-family ipv4
  address 10.10.10.1 primary
  priority 100
  exit-vrrp
La syntaxe VRRP diffère selon les versions d'IOS (certaines exigent fhrp version vrrp v3 au préalable) ; consultez la documentation de votre plateforme. Les postes utilisent 10.10.10.1 comme passerelle. Le routeur de plus haute priorité devient maître ; la préemption lui permet de reprendre ce rôle après son retour.
Suivi d'objet
Un routeur maître dont le lien vers Internet est coupé reste maître… et envoie le trafic dans une impasse. Le suivi d'objet (object tracking) diminue sa priorité lorsqu'une interface ou une destination devient injoignable, provoquant la bascule vers l'autre routeur.
Agrégation de liens
L'agrégation (LACP, IEEE 802.1AX) combine plusieurs liens physiques en un lien logique : la perte d'un membre n'interrompt pas le trafic. Avec des commutateurs supportant l'agrégation multi-châssis (empilement, MLAG, vPC), on peut répartir les membres sur deux équipements distincts et survivre à la perte d'un commutateur entier. Voir EtherChannel : agrégation de liens.
Redondance de couche 2 et Spanning Tree
Doubler les liens entre commutateurs crée des boucles, que le protocole Spanning Tree neutralise en bloquant certains ports. RSTP réduit le temps de reconvergence à quelques secondes au plus, souvent bien moins. Voir STP et RSTP : prévention des boucles réseau. Les architectures modernes limitent toutefois le rôle de STP en privilégiant l'agrégation multi-châssis et le routage dès la couche de distribution.
Redondance du routage
Avec plusieurs chemins et un protocole de routage dynamique (OSPF, BGP), le réseau reconverge automatiquement autour d'une panne. Les temps de détection peuvent être réduits avec BFD (Bidirectional Forwarding Detection, RFC 5880), qui détecte la perte d'un voisin en quelques centaines de millisecondes ou moins, au lieu d'attendre l'expiration des temporisateurs du protocole.
Pour l'accès Internet, deux liens peuvent être exploités :
- en actif/passif, avec une route par défaut flottante et un suivi de la joignabilité ;
- avec BGP et un bloc d'adresses propre, pour une redondance complète entre opérateurs (au prix d'une complexité accrue). Voir BGP : principes fondamentaux.
Clusters et répartition de charge des services
- Pare-feu en cluster actif/passif : synchronisation des sessions pour une bascule transparente.
- Répartiteurs de charge (HAProxy, Nginx, appliances) devant plusieurs serveurs, avec contrôles de santé.
- Adresse virtuelle partagée par une paire de répartiteurs, souvent via VRRP (keepalived sous Linux).
Exemple minimal avec keepalived (laboratoire) :
vrrp_instance VI_WEB {
    state BACKUP
    interface ens18
    virtual_router_id 51
    priority 110
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass <secret>
    }
    virtual_ipaddress {
        10.10.20.100/24
    }
}
Tester les bascules
Une redondance jamais testée est une redondance supposée. Organisez des tests planifiés :
- Documenter le scénario (coupure d'un lien, arrêt d'un routeur, d'une alimentation).
- Prévenir les utilisateurs et prévoir un retour arrière.
- Mesurer l'impact réel : nombre de pings perdus, sessions coupées, durée de reconvergence.
- Vérifier le retour à la normale (préemption, resynchronisation).
- Corriger et documenter.
Un ping continu horodaté pendant le test donne une mesure simple et objective de l'interruption.
Erreurs courantes
- Redondance apparente : deux liens dans la même gaine, deux serveurs sur le même hôte.
- FHRP sans suivi d'objet, maître actif mais coupé de l'extérieur.
- Configurations divergentes entre les deux membres d'une paire.
- Complexité excessive : une architecture que personne ne comprend devient elle-même une source de pannes.
- Absence de tests de bascule.
Implications de sécurité
Les protocoles de bascule doivent être protégés : authentification VRRP/HSRP lorsque disponible (en gardant à l'esprit que certaines méthodes sont faibles), filtrage des messages sur les segments utilisateurs, et surveillance des changements de rôle maître/secours, qui peuvent signaler une panne… ou une tentative d'usurpation.
Conclusion
La haute disponibilité commence par la définition du RTO et du RPO, se poursuit par la chasse aux points de défaillance uniques et se concrétise par des mécanismes adaptés : FHRP, agrégation, routage dynamique, clusters. Elle ne vaut que par ses tests. Pensez enfin à la sauvegarde des configurations, dernier filet de sécurité.