Pare-feu : règles de filtrage et bonnes pratiques
Un pare-feu n'est efficace que par la qualité de ses règles. Politique par défaut, ordre d'évaluation, filtrage sortant, journalisation et revue régulière : les bonnes pratiques pour une politique lisible et sûre.
Le pare-feu est l'équipement de sécurité réseau le plus répandu, mais aussi l'un des plus mal exploités. Au fil des années, les règles s'accumulent, les exceptions temporaires deviennent permanentes et plus personne ne sait pourquoi un flux est autorisé. Une politique de filtrage efficace est minimale, ordonnée, documentée et revue régulièrement.
Objectif : comprendre les types de pare-feu et la logique d'évaluation des règles, puis appliquer des bonnes pratiques de conception et de maintenance. Les exemples sont fournis à titre pédagogique, pour des environnements de test ou des réseaux dont vous avez la responsabilité.
Les grandes familles de pare-feu
| Type | Niveau d'analyse | Exemple d'usage |
|---|---|---|
| Filtrage de paquets sans état | Adresses, protocole, ports, paquet par paquet | ACL de routeur |
| Pare-feu à états (stateful) | Suivi des connexions | Pare-feu périmétrique, nftables, pare-feu des systèmes |
| Pare-feu applicatif / « nouvelle génération » | Identification des applications, utilisateurs, inspection du contenu | Filtrage par application, prévention d'intrusion intégrée |
| Pare-feu applicatif web (WAF) | Requêtes HTTP | Protection d'applications web |
Le suivi d'état
Un pare-feu à états garde en mémoire les connexions établies. Lorsqu'une règle autorise un poste interne à ouvrir une connexion HTTPS, les réponses du serveur sont automatiquement acceptées, car elles appartiennent à une connexion connue. Il n'est donc pas nécessaire d'ouvrir les ports éphémères en entrée, ce qu'imposerait un filtrage sans état.
Les états courants sont : new (nouvelle connexion), established (connexion établie), related (flux associé, comme un message ICMP d'erreur lié à une connexion) et invalid (paquet incohérent, à rejeter).
Comment les règles sont évaluées
Sur la plupart des pare-feu, les règles sont évaluées de haut en bas, et la première règle qui correspond s'applique (first match). Conséquences :
- une règle large placée trop haut masque toutes les règles plus spécifiques situées en dessous ;
- l'ordre est une partie intégrante de la politique ;
- une règle par défaut s'applique lorsqu'aucune autre ne correspond.
1. Autoriser  10.10.99.0/24 → 10.10.20.0/24  TCP 22      (administration)
2. Refuser    tout          → 10.10.20.0/24  TCP 22      (SSH interdit ailleurs)
3. Autoriser  10.10.10.0/24 → 10.10.20.80    TCP 443     (application web)
4. Refuser    tout          → tout                        (règle par défaut, journalisée)
Si l'on inverse les règles 1 et 2, plus aucun administrateur ne peut se connecter en SSH.
Les bonnes pratiques de conception
1. Politique par défaut : tout refuser
Autorisez explicitement les flux nécessaires et refusez tout le reste. C'est l'application directe du moindre privilège. La politique inverse (« tout autoriser sauf… ») laisse passer tout ce que l'on n'a pas imaginé.
2. Des règles précises
Chaque règle précise source, destination, protocole et port. Évitez les règles « any/any » et les plages de ports entières. Une règle « 10.10.10.0/24 → serveur web, TCP 443 » est préférable à « LAN → DMZ, tout ».
3. Utiliser des objets nommés
Les pare-feu permettent de définir des objets (SRV-WEB-PROD, RES-ADMIN, SVC-HTTPS) et des groupes. Les règles deviennent lisibles et la modification d'une adresse se fait en un seul endroit.
4. Filtrer aussi en sortie
Le filtrage sortant est souvent négligé, alors qu'il limite fortement l'impact d'une compromission :
- les serveurs n'ont généralement besoin de joindre qu'un nombre restreint de destinations (dépôts de mises à jour, services partenaires) ;
- les postes peuvent être contraints de passer par un proxy pour le Web ;
- seuls les résolveurs DNS internes interrogent l'extérieur sur le port 53 ;
- SMTP sortant est limité aux serveurs de messagerie.
Un logiciel malveillant qui ne peut pas joindre son serveur de commande est largement neutralisé.
5. Documenter chaque règle
Pour chaque règle : justification, demandeur, date de création, date de revue (et date d'expiration pour une règle temporaire). Les pare-feu modernes offrent un champ de commentaire : utilisez-le systématiquement.
6. Journaliser intelligemment
- Journalisez les refus de la règle par défaut, pour détecter les tentatives et les erreurs de configuration.
- Journalisez les autorisations des flux sensibles (administration, accès aux données).
- Envoyez les journaux vers un serveur central ou un SIEM. Voir Journalisation et supervision des événements de sécurité.
7. Ne pas bloquer aveuglément ICMP
Les messages d'erreur ICMP sont nécessaires au bon fonctionnement du réseau, notamment à la découverte de MTU. Filtrez finement plutôt que de tout bloquer. Voir MTU, MSS et fragmentation des paquets.
Exemple : politique d'un serveur avec nftables
#!/usr/sbin/nft -f
# Exemple de laboratoire : serveur web administré depuis 10.10.99.0/24
flush ruleset
table inet filtre {
  set admins {
    type ipv4_addr; flags interval;
    elements = { 10.10.99.0/24 }
  }
  chain entree {
    type filter hook input priority 0; policy drop;
    ct state established,related accept
    ct state invalid drop
    iif "lo" accept
    meta l4proto icmp icmp type { echo-request, destination-unreachable, time-exceeded } accept
    meta l4proto ipv6-icmp accept
    tcp dport 22 ip saddr @admins accept comment "SSH depuis le réseau d'administration"
    tcp dport { 80, 443 } accept comment "Service web public"
    limit rate 5/minute log prefix "nft-refus: " level info
  }
  chain sortie {
    type filter hook output priority 0; policy accept;
  }
}
La politique de sortie est ici permissive pour simplifier ; sur un serveur exposé, elle peut être restreinte aux destinations nécessaires. La règle de journalisation est limitée en débit pour ne pas saturer les journaux.
Maintenir la politique dans le temps
- Revue périodique (par exemple semestrielle) : chaque règle est-elle encore justifiée ? A-t-elle été utilisée récemment ? Les compteurs de correspondance (hit counts) aident à identifier les règles mortes.
- Suppression des règles temporaires à leur échéance.
- Processus de changement : demande, analyse, validation, mise en œuvre, vérification.
- Contrôle des règles en double ou masquées par une règle plus large.
- Sauvegarde de la configuration avant toute modification.
Pare-feu et architecture
Le pare-feu prend tout son sens dans une architecture segmentée : zones Internet, DMZ, serveurs, utilisateurs, administration, avec des règles explicites entre chaque zone.
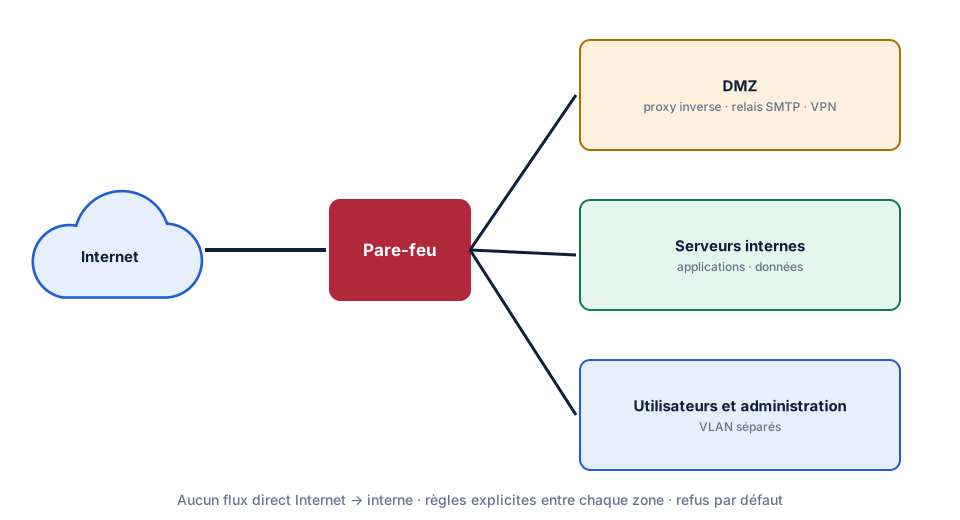
Voir Segmentation réseau et réduction de la surface d'attaque.
Erreurs courantes
- Règles « any/any » temporaires jamais supprimées.
- Ordre incorrect, une règle large masquant des refus spécifiques.
- Absence de filtrage sortant.
- Exposition des interfaces d'administration du pare-feu lui-même sur Internet.
- Correctifs non appliqués sur le pare-feu : les équipements de bordure sont des cibles prioritaires.
- Journalisation désactivée pour « économiser des ressources ».
Conclusion
Un bon pare-feu, c'est d'abord une bonne politique : tout refuser par défaut, autoriser précisément, filtrer en entrée et en sortie, documenter, journaliser et revoir. L'équipement le plus avancé ne compensera jamais une politique incohérente. Pour le filtrage directement sur les routeurs, voir ACL Cisco : contrôle du trafic réseau.